「似ているもの」を引ける、新しい棚の形
図書館で「著者名」や「本棚の番号」で目的の本を探すのは簡単ですが、「感動する本」や「旅に出たくなる本」といったテーマで探そうとすると、従来の整理番号だけでは見つけるのが難しくなります。ベクトルデータベース(Vector Database)は、まさにこの「意味や雰囲気」で検索できる新しいデータベースです。
文章や画像などのデータを「意味の座標(ベクトル)」に変換して蓄え、入力された質問やデータと“空間上の距離が近いもの”を探して返してくれます。
「検索」と言っても、言葉の一致探しじゃない
たとえば「猫の画像」を検索する場合、従来の検索は「cat」「猫」というキーワードがファイル名や説明文に含まれているかを探します(完全一致・キーワード検索)。一方、ベクトル検索はデータそのものの特徴を数値で測り、「意味や見た目が近いもの」を並べ替えます。だからこそ、表記や言葉が違っていても同じ意味として拾い上げることができます。
- FAQ検索で「支払いのやり直し方法」と聞くと、文章内に“やり直し”がなくても「再決済の手順」の記事を上位に返せる
- 画像検索で「夕焼けの海」を頼むと、タグに該当語がなくても見た目の構図が似ている候補を出せる
- 社内文書検索で「遅延時の連絡手順」と入力すると、「障害発生時のエスカレーション」の文書を引き出せる
共通しているのは、入力されたデータと検索候補を同じ“多次元の数値空間”に置き、距離の近さで順位(類似度)をつける仕組みです。
「普通のDB(RDB)」と何が違うのか
混同しやすいのは、SQLで操作する従来のリレーショナルデータベース(RDB)です。両者は「データを保存する場所」という点では共通していますが、探すための軸や目的が大きく異なります。
- RDB:「価格が3000円以下」「会員ID=100」のように明確な条件に“完全一致するか”でデータを絞り込む
- ベクトルDB:「この文章と文脈が近いもの」のように数値の距離(類似度)で上位N件(Top-K)を抽出する
- 使い分け:正確な数値やIDの一致が必要な業務データはRDB、あいまいな文章・画像・類似検索が必要なAI領域はベクトルDB
この違いを押さえておくと、「条件一致のRDB」と「類似度順のベクトルDB」という役割分担がクリアに見えてきます。
まとめ:生成AIを支える基盤
ベクトルデータベースの真価は、検索の軸を「言葉の一致」から「意味の近さ」へシフトさせた点にあります。生成AI(LLM)が外部の専門知識を参照して答えるRAG(検索拡張生成)においても、必要な情報を高速かつ高精度に引き出すための決定的なインフラとなっています。
- 初心者向け:今週できる1ステップ — AIツールで「完全なキーワードを入れず、似た意味の言葉」で検索して目的の回答が出るか試してみる。
- 受験者向け:試験の3語の要点 — 「ベクトル(多次元数値)の蓄積」「類似度(距離)による探索」「RAGを支えるデータベース」。
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
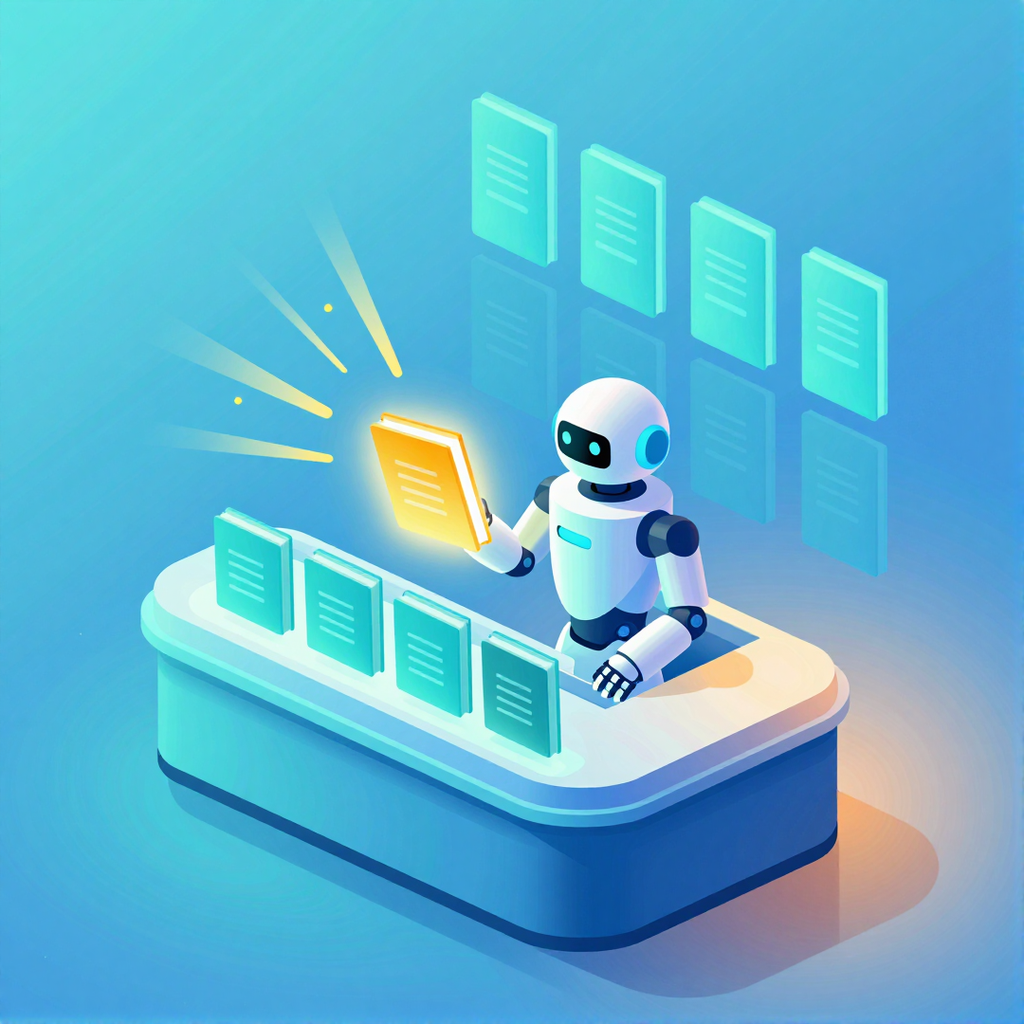
ベクトルデータベースの「近いものを選ぶ」構造が明快で、 光る1枚と沈む複数の対比が印象的です。一方で、空間的距離 がやや弱く、検索の意味が少し抽象的に感じられました。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 4 | 多数から近い1件を選ぶ構造が表現できています |
| 比喩の明快さ | 5 | 光る1枚が視覚的焦点として非常に明快です |
| 立体感・奥行き | 3 | 奥行き感はありますが距離空間の提示はやや弱いです |
| 映え度(SNS寄与) | 4 | 清潔感とアクセント光のバランスがSNS映えします |
| 色調の用語相性 | 4 | シアン基調が技術的な清潔感と相まって好印象です |
| 合計 | 20 / 25 | 総合判定: 良好 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価
コメント