この記事では、RAG(検索拡張生成)の仕組みをわかりやすく解説します。
RAGを理解するために必要となる「LLM」「ハルシネーション」「グラウンディング」などの関連用語についても、あわせて紹介していきます。
RAGの仕組みを理解したい方はもちろん、G検定などの資格試験の勉強にもご活用ください。
RAGの仕組み
RAGとは?
RAGとは、日本語で「検索拡張生成」といい、Retrieval-Augmented Generationの略です。
生成AIが持っている知識だけでは回答できない質問に対して、外部の資料やデータを検索し、その情報を参考にして回答を生成する仕組みです。
例えば、ChatGPTのような生成AIは、学習したデータをもとにさまざまな質問に回答できます。
しかし、次のような情報については、AIがもともと知っているとは限りません。
- 社内だけで利用している業務マニュアル
- 自分で作成した資料
- 社内の最新情報
- 学習後に公開された最新情報
そこでRAGでは、ユーザーの質問に関連する資料を外部のデータベースなどから検索して取り出し、その情報をLLMに渡します。
LLMは検索された情報を参考にして回答を生成します。
つまり、RAGを一言で表すと、
「必要な情報を検索して、その情報をもとにLLMに回答させる仕組み」
と考えると分かりやすいでしょう。
これにより、LLMがもともと持っている知識だけでなく、最新情報や社内データなどの外部情報を回答に活用できるようになります。
🔎 RAGの仕組みを直感で理解!
RAGとは?
LLMとはどう違うのか?
では、RAGとLLMは何が違うのでしょうか。
実は、RAGで最終的に「文章」を生成しているのはLLMです。
LLMとは「Large Language Model(大規模言語モデル)」のことで、ChatGPTなどの生成AIサービスの中核となる技術です。
LLMの基本的な仕組みは、入力された文章の文脈から、次に続く可能性の高いトークンを予測することです。
例えば、
「今日はいい天気なので、____」
という文章が入力された場合、LLMは文脈から「散歩に行こう」「外に出かけよう」など、続きとして自然な言葉を予測します。
この処理を繰り返すことで、質問に対する自然な文章を生成します。
しかし、ここには注意すべき点があります。
LLMが持っている知識は、基本的には学習によって獲得した知識です。
そのため、学習時点では存在しなかった最新情報や、社内だけで利用されている情報などについては、LLMがもともと知っているとは限りません。
そこで登場するのがRAGです。
RAGでは、LLMが持っている知識だけに頼るのではなく、必要な情報を外部の資料から検索し、その情報をLLMに渡します。
イメージすると、次のような違いです。
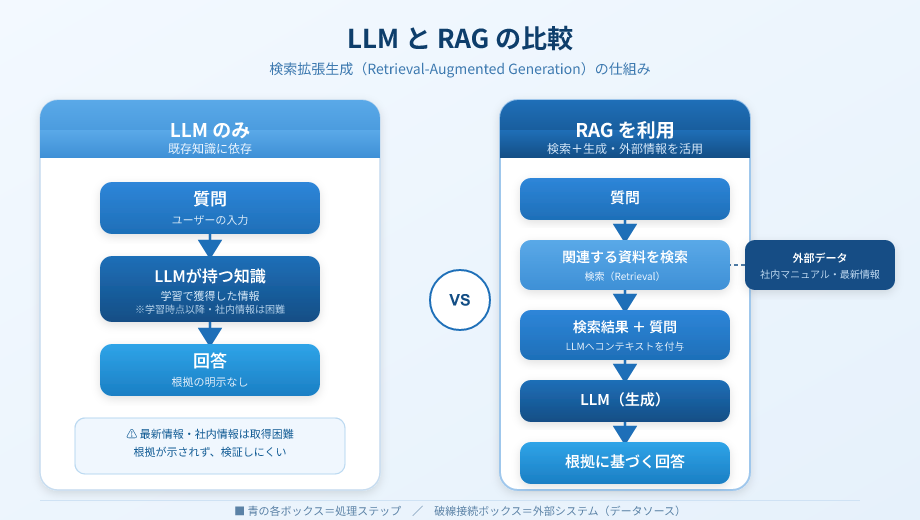
つまり、RAGはLLMそのものを置き換える技術ではなく、LLMに外部の情報を提供する仕組みなのです。
🔎 LLM仕組みを直感で理解!
LLMとは?
なぜRAGが注目されているのか?
RAGが注目されている大きな理由の一つが、LLMのハルシネーション対策です。
ハルシネーションとは、生成AIが事実とは異なる情報を、もっともらしい文章として生成してしまう現象です。
例えば、
- 存在しないサービス名を答える
- 間違った数値を提示する
- 実在しない論文や判例を紹介する
- 質問に対して事実とは異なる説明をする
といったことがあります。
なぜ、このようなことが起こるのでしょうか。
LLMは「次にどのようなトークンが続く可能性が高いか」を予測して文章を生成します。
そのため、文章として自然であることと、内容が事実であることは別問題です。
LLMは文章を自然に生成できても、その情報が本当に正しいのか、最新なのか、特定の社内資料と一致しているのかを、必ずしも保証できません。
特に次のような情報は、LLMだけでは扱いにくい場合があります。
- 最新情報:学習後に発生したニュースや製品アップデートなど
- 社内情報:社内規定、業務マニュアル、顧客情報など
- 個人情報・独自情報:自分だけが持っている資料やデータなど
そこでRAGでは、回答に必要な情報を外部の資料から検索して取得し、その情報を根拠としてLLMに回答させます。
これにより、LLMが持っている知識だけに頼る場合と比べて、最新情報や特定の資料に基づいた回答を生成しやすくなります。
ただし、ここで重要な注意点があります。
RAGを使えば、ハルシネーションが完全になくなるわけではありません。
検索する資料が間違っていたり、必要な情報を正しく検索できなかったり、LLMが検索結果を誤って解釈したりする可能性があります。
そのため、RAGはハルシネーションを「なくす」仕組みではなく、発生する可能性を抑え、回答を根拠となる情報に結びつけるための仕組みと考えるのが適切です。
G検定を受験する予定の方はこちらがおすすめ!
公式テキストは用語を網羅しています。これを読むのは必須です👇
🔎 ハルシネーション仕組みを直感で理解!
ハルシネーションとは?
では、ハルシネーションに騙されないためには?
ここまで説明したハルシネーションの厄介なところは、間違った情報でも自然な文章として生成されるため、人間が気づきにくいことです。
そこで重要になるのが、回答の根拠を示すことです。
この考え方を表す重要な用語が「グラウンディング」です。
グラウンディングとは?
グラウンディング(Grounding)とは、LLMの回答を現実の情報や信頼できる外部データなどの根拠に結びつける考え方・仕組みです。
例えば、
「この回答は、社内規定の○○という文書をもとに生成しました」
というように、回答の根拠となる情報を示すことで、ユーザーが回答内容を確認しやすくなります。
なぜ、これが重要なのでしょうか。
一番の理由は、人間が回答の正しさを検証しやすくなるからです。
根拠となる資料が示されていれば、その資料を開いて内容を確認できます。
回答と資料の内容が一致していれば、回答の妥当性を確認できます。
反対に、資料に書かれていない内容をAIが勝手に生成していれば、
「この回答は本当に正しいのだろうか?」
と気づくきっかけになります。
つまり、AIの回答を単純に「鵜呑みにする」のではなく、人間が確認・検証できる回答にすることが、グラウンディングの重要な役割です。
また、回答の根拠を明確にできることは、業務でAIを利用する場合にも重要です。
例えば、社内規定についてAIに質問したとき、
「○○という規定の第△条を根拠に回答しています」
と示されれば、利用者は回答の内容を確認できます。
このように、回答を根拠となる情報に結びつけることで、AIの回答をより検証しやすくすることができます。
RAGは、このグラウンディングを実現する代表的な方法の一つです。
RAGでは、質問に関連する外部資料を検索し、その情報をLLMに渡して回答を生成します。
そのため、「検索した情報を根拠として回答を生成する」というRAGの仕組みは、グラウンディングと非常に相性が良いのです。
RAGの基本をまとめると
ここまでの内容を整理すると、RAGは次のような仕組みです。
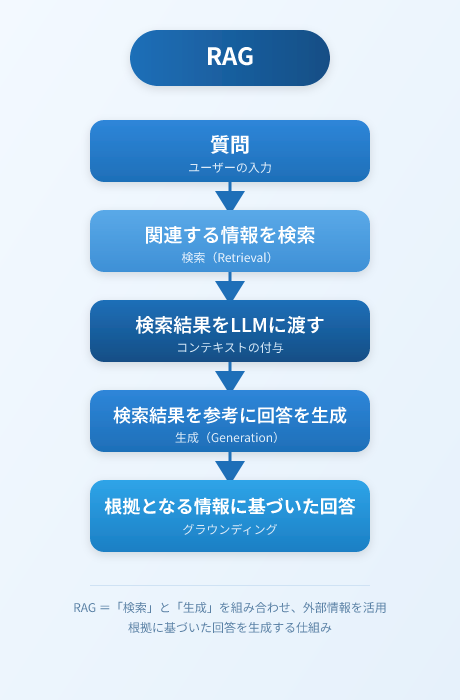
つまり、
RAG=「検索(Retrieval)」と「生成(Generation)」を組み合わせ、外部情報を活用してLLMに回答させる仕組み
です。
LLMだけでは扱いにくい最新情報や社内情報などを活用できること、そして回答を外部の根拠となる情報に結びつけられることが、RAGが注目される大きな理由です。
次章では、RAGが実際にどのような流れで情報を検索し、LLMが回答を生成しているのか、「検索 → 取得 → 生成」の具体的な仕組みを詳しく見ていきます。
RAGについて、もう少し体系的に勉強したい方はこちら👇
この記事で出てきた用語を個別に解説しています🔗
コメント