AIの「正解」を、誰が採点しているのか
新入社員に「この企画案、どうですか?」と聞かれたら、どう判断しますか。評価基準のリストを渡しても、最終的にはあなた自身が「うん、これは行けそうだ」「これはまだだな」と、自分の体感で採点しているはずです。
AIのモデル評価にも、似た「人間の味見」が必要になります。スコアを機械的に測るのは簡単でも、「読み手として気持ちよく読めるか」「業務でそのまま使えそうか」といった質は、人間の五感に委ねる場面がどうしても残ります。ローブナーコンテストは、まさにその「人間の採点」を構造化して行う仕組みです。
つまり、AIモデルの回答を人間が比較・採点し、品質や妥当性を定性的に評価する手法です。
「AIは勝手に点数をつけてくれる」と思っている人へ
「ローブナーコンテスト=AIがAIを採点する自動化テスト」と誤解している声をよく聞きます。これは半分正しく、半分違います。
- 「完全な自動採点ではない」:最終的な判断軸には「人間が妥当と判断した回答の傾向」が基準として入っており、機械スコアだけで完結しない
- 「1回で終わりではない」:同じ質問に複数回答を出し、評価者間で採点のズレ(採点者間信頼性)を調整しながら評価を繰り返す構造
- 「正解の採点ではない」:事実誤認(ハルシネーション)がある回答を「自然に書けている」から高く採点してしまうリスクがあり、事実確認との併用が前提
この「ズレ」が気付きにくいほど、評価結果の信頼度が下がります。
実際に「人間の採点」が走る場面
- モデル導入前の比較検証:2つのLLM(大規模言語モデル)から同じプロンプト(指示文)で回答を出し、社内の評価委員が「業務で使えるレベルか」を5段階で採点してA/B比較する
- 顧客対応トーンの評価:「丁寧だが押しつけがましい」回答と「簡潔だが冷たい」回答を並べ、CS(カスタマーサクセス)の現場経験者が「顧客が離脱しにくい方」を採点する
- 新バージョンの品質回帰チェック:モデル更新後に「以前より回答が長くなり、要点がぼやけていないか」を確認するため、過去の採点基準(ルーブリック)を適用して人間が再採点する
共通するのは、「スコアでは測れない部分」を人間の判断で補っている、という点です。
G検定で問われる「モデル評価」の位置づけ
G検定(AIスキル・G検定)では、AIの性能評価と品質管理が出題範囲に含まれます。ローブナーコンテストは「LLMの出力をどう評価・管理するか」の文脈で問われる典型的な手法です。
出題アングルとしては、「自動評価と人間評価の使い分け」「評価者間の一貫性(採点者間信頼性)の確保」がポイントになります。
確認方法:「なぜスコアだけで判断できないのか」を、具体的な業務例を1つ挙げて説明できるかどうかで、自分の理解度を測ってみてください。
まとめ
ローブナーコンテストは、AIの回答を「人間が採点して品質を測る」構造化された評価手法です。自動評価スコアと補完し合い、モデルの真の品質を可視化します。
- 【今週にできる5分のアクション】:手元のAIツールで同じ質問を2回問い、2つの回答を並べて「自分の目でどちらが業務で使えると感じるか」を3段階(使える/要修正/使えない)で採点してみてください。その「自分の基準」が、実はローブナーコンテストの核心です
- 【試験で出たときの3語の要点】「人間採点」「採点者間信頼性」「自動評価の補完」
📚 さらに理解を深めたい方には、G検定の公式テキストがお薦めです!
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
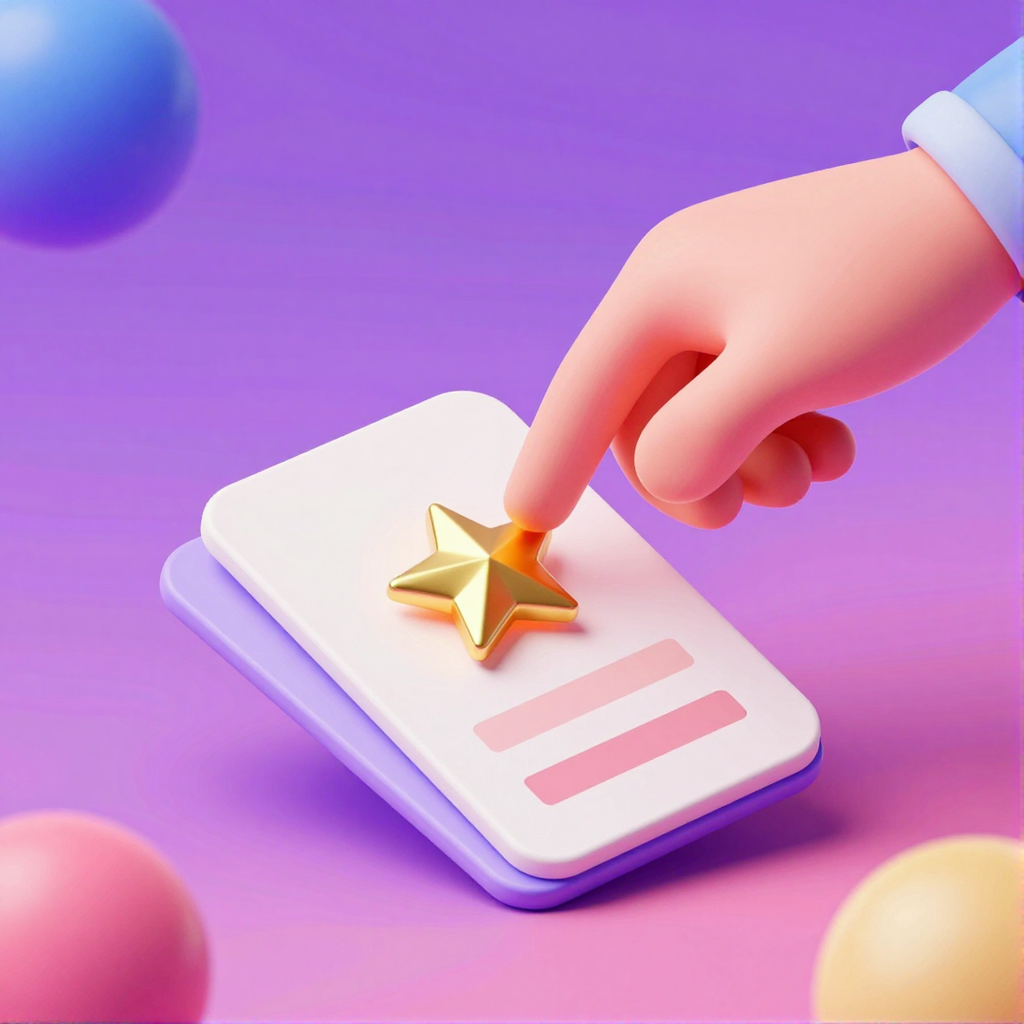
ローブナーコンテストの「人間の採点」が星の付与で一目で伝わります。手元の選択アクションが自然で視覚的に引きつけますが、比較対象の2つの回答カードの区別がやや弱く、対比が少し弱いです。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 4 | 人間の選択で回答を決める様子が伝わります |
| 比喩の明快さ | 5 | 星を貼る行為が採点を即座に示します |
| 立体感・奥行き | 4 | 影と光の配置で立体感が安定しています |
| 映え度(SNS寄与) | 4 | 金色の星が画面の注目点を明確にします |
| 色調の用語相性 | 4 | 柔らかい色味が評価の穏やかさを表します |
| 合計 | 21 / 25 | 総合判定: 優秀 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価

コメント