「ジャストサイズ」を数式で測る基準
コンビニで試着した服を思い出してください。大きすぎると肩からすっと落ち、小さすぎると腕が引っかかる。BIC(ベイズ情報量規準、Bayesian Information Criterion)が求めているのは、ちょうどいいサイズ選びそのものです。
つまり、モデルの”当てはまる度合い”を高く評価しつつ、同時に”パラメータ(調整するノブ)が多いこと”を罰点で引き算する、モデル選びの評価指標です。
あなたの身近で、もうBICは動いている
「AIの話」としてだけ見ると遠い存在に見えますが、実は日常の”選び方”でBICの思考はすでに使われています。
- 服のサイズ選び:「Mで十分なのに、なぜLを買った?」と同じ問いをモデルに投げているのがBICです
- 写真のフィルタ選び:色味・コントラスト・ノイズ除去を全部ONにすれば画質は”きれい”に見えますが、実は”加工しすぎ”。BICはそれを点数で表す
- 天気の予想:「晴れ」とだけ言う人と、「雲量・湿度・風向・前日の雨量」まで使う人。どっちの天気予報が明日の傘判断に役立つか、BICはそこで選別します
つまり、BICは”知識が多いほど優れている”という直感を、点数で一度ひっくり返す装置です。
BICを使う流れ
BICについて、多くの人が最初にする誤解
初めて「BIC」という言葉を耳にしたとき、多くの人がつまずくのは、以下の3点です。
- 「BICが低いほど、何でもモデルとして優れている」と思っているが、低いのは”そのデータ・その問い”に対してのこと。別のデータでは逆転します
- 「パラメータを増やせば、評価は必ず良くなる」と思っているが、BICはパラメータ数を罰で引いており、増やすほど下がるわけではありません
- 「AIC(赤池情報量規準、Akaike Information Criterion)とBICは同じ」と思っているが、パラメータへの罰の重さが違い、候補モデルに差が出ます
この”違い”を自分の言葉で説明できるかどうかで、理解の段数が変わります。
AIC(赤池情報量基準)との違い
AICとの違いは下記に図示します。
G検定の”モデル選択”で、BICが出題される角度
G検定では、モデルの良し悪しをどう決めるかという”モデル選択”が頻出テーマです。
BICはそこで、”当てはまる度合いだけを見るとパラメータが多いモデルが勝つ、しかし汎化(未見のデータでの働き)では逆転しうる”という説明の根拠として出題されます。
確認方法は1つ:ノートを開き、”BICはAICと何が違うか”を30秒で口に出せるか。言えなければ、”罰の重さ”の1行だけ覚えます。
まとめ
BICは、”モデルの当てはまり”と”パラメータの多さ”を点数で両立させるための、ジャストサイズのメジャーです。
- 今週の5分アクション:手元の分析で”パラメータを1つ増やしたらスコアがどう変わったか”を1回だけ記録し、”増やすほど良くなるのか”を自分の目で確かめる
- G検定の3語の要点:当てはまり・罰・汎化
📚 さらに理解を深めたい方には、G検定の公式テキストがお薦めです!
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
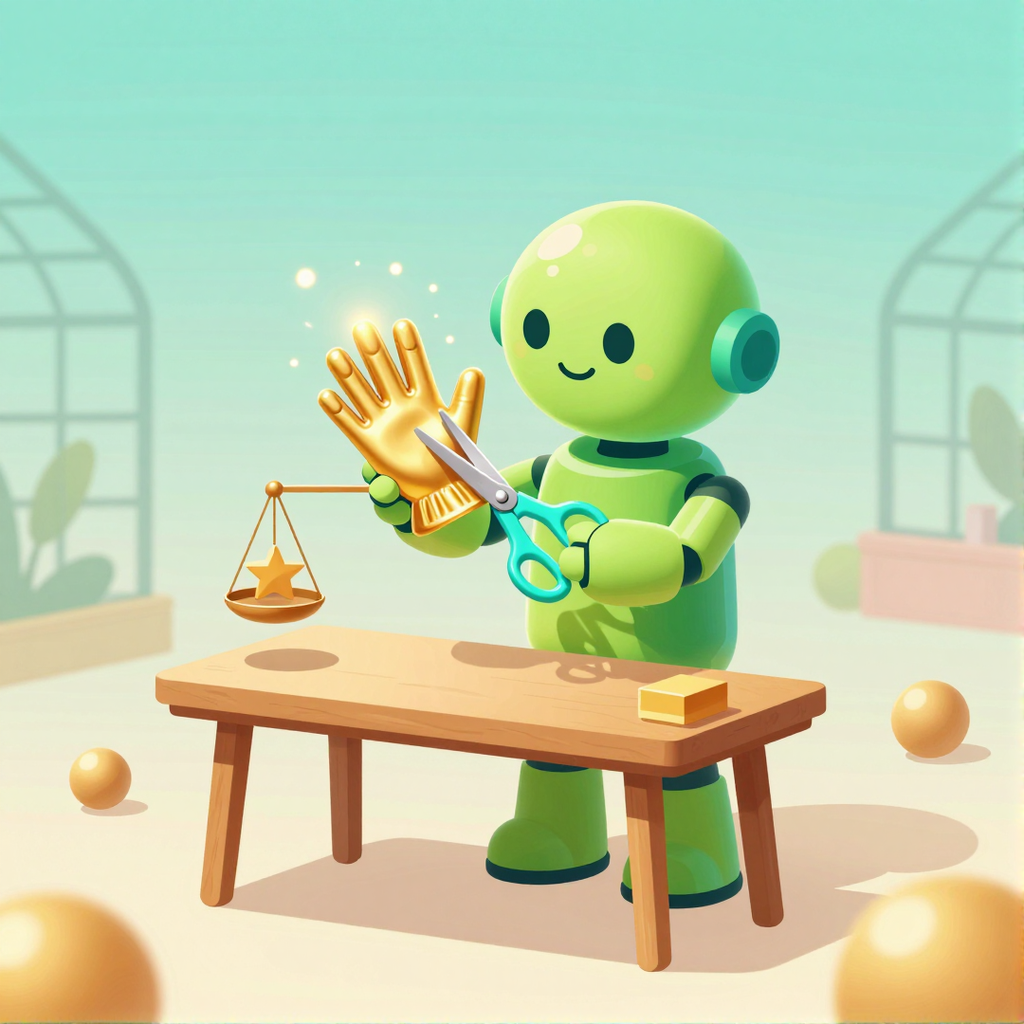
ベイズ情報量規準の「最適なモデル選び」が、ロボットのハサミによる 過剰要素の除去という比喩で明快に伝わります。 一方で、奥行きと立体感がやや平面寄りで、立体感に物足りなさを感じます。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 4 | 最適化の「バランス取り」が伝わる構成です |
| 比喩の明快さ | 4 | ハサミで不要部分を切る比喩が一瞬で理解できます |
| 立体感・奥行き | 3 | 影が薄く、奥行きがやや弱い印象です |
| 映え度(SNS寄与) | 4 | 黄金グローと緑の対比が目を引きます |
| 色調の用語相性 | 4 | 冷静で知的な緑×金の配色が相性よく機能しています |
| 合計 | 19 / 25 | 総合判定: 良好 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価
コメント