味を「全部同じくらい」に抑える感覚で掴める
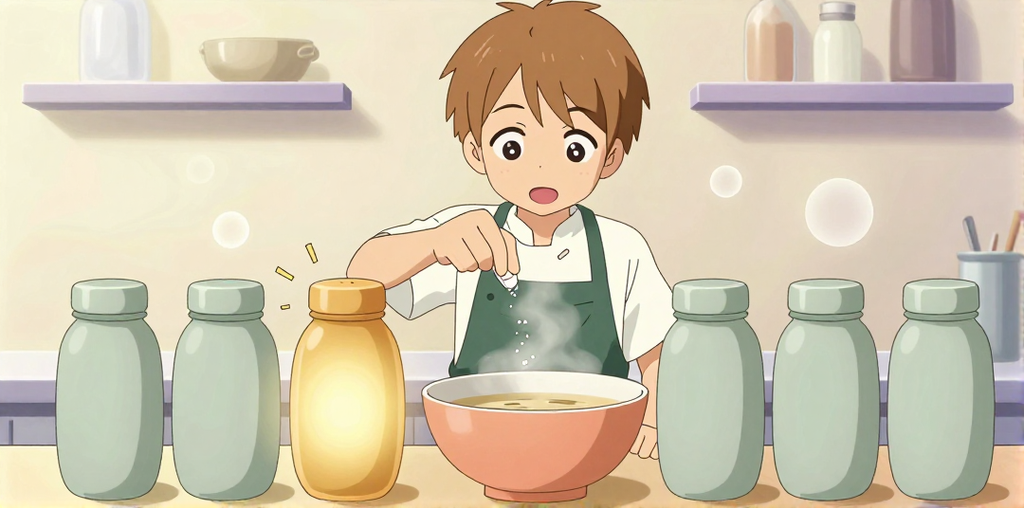
想像してみてください。料理の味が、塩や胡椒など特定の調味料だけに偏りすぎて不自然になっています。L2正則化は、そうした「特定の調味料の強すぎる主張」を抑え、全体的に重みを少しずつ削ってバランスを整える働きをします。
つまり、L2正則化(Ridge回帰)は、重みの大きさを全体的に小さく抑えることで、モデルの挙動を穏やかにし、過学習(overfitting)を防ぐための仕組みです。
あなたの業務で、L2正則化が効く場面
「正則化って難しい」と感じる前に、生活や業務の文脈で触れている場面があるかもしれません。
- 予測モデルが、少数のデータや極端な値(外れ値)に強く依存して結果が不安定なとき
- 似たような意味を持つデータが多く、どれか1つに絞らず全体的にマイルドに反映させたいとき
- モデルの挙動を「穏やか」にして、未知のデータに対しても安定した予測を出したいとき
この「尖った部分を小さく抑える」力は、料理の味を調える感覚と似ています。1つの味だけを突出させるのではなく、全体のバランスを整えて角を取るイメージです。
G検定・データサイエンティスト検定で問われる「自分の言葉」
L2正則化は、G検定とデータサイエンティスト検定の両方で「過学習対策」として出題されます。
出題アングルは主に2つ:
- 「過学習を防ぐ手法として正しいのはどれか」でL2正則化が選択肢に入る
- 「L1正則化とL2正則化の違い」を問われ、L1は重みをゼロにする(変数選択)のに対し、L2は重みを小さく抑えるがゼロにはしない点が答えになる
「L2正則化が、重みを完全にゼロにせず『全体的に小さく抑える』のはなぜ?」
この1問に「特定の変数に依存しすぎるのを防ぎ、全体の影響力をマイルドに保つため」と答えられれば、試験対策はバッチリです。
まとめ
L2正則化の核は、「重みの暴走を抑え、全体をマイルドにする」という一点です。料理でいうと、特定の味が主張しすぎないように角を削り、自然なバランスに戻すのと同じ。
- 今週にできる5分のアクション:分析データの中で、「特定のデータに強く影響されすぎていないか」を確認してみる
- 試験で出たときの3語の要点:「重みを小さくする」「過学習対策」「ゼロにはしない(Ridge)」
📚 さらに理解を深めたい方には、G検定の公式テキストがお薦めです!
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
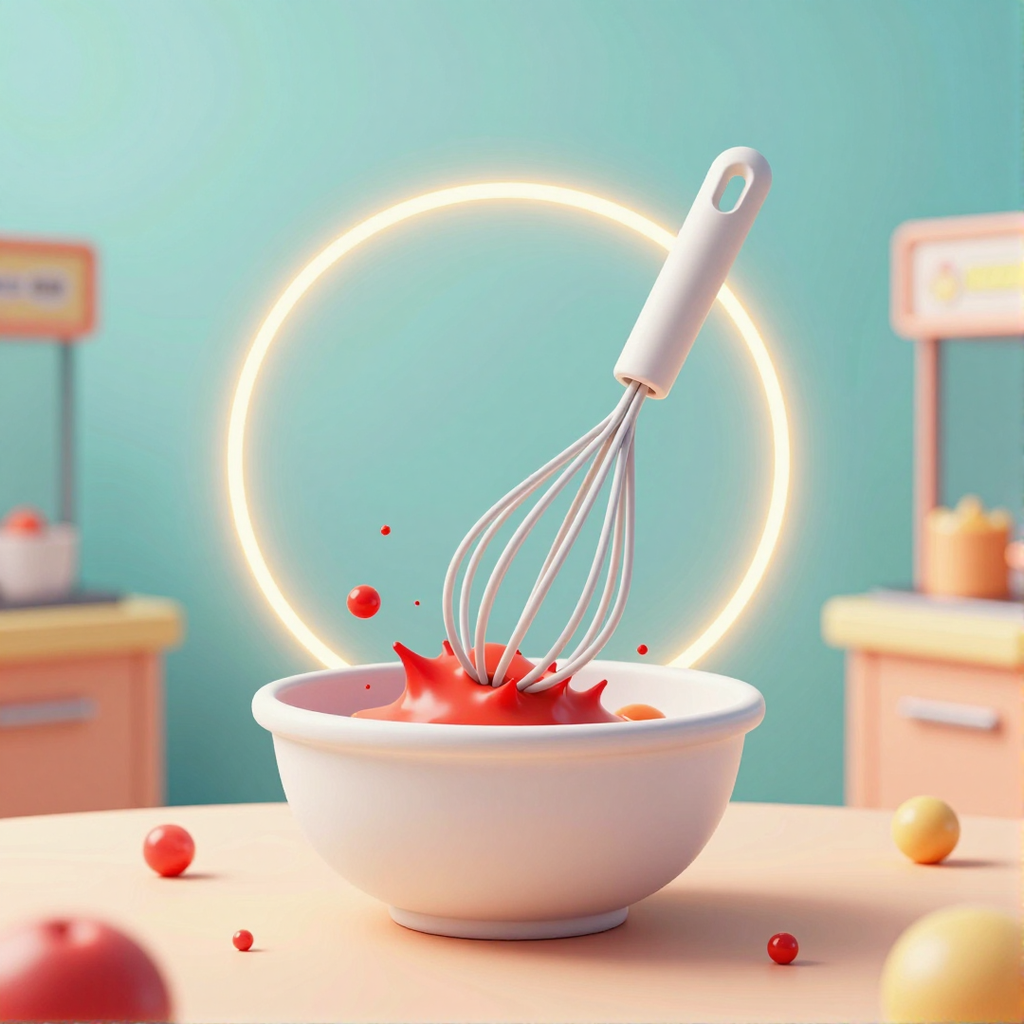
L2正則化の「全体的な抑制」が料理の混ぜ合わせで表現されており、 3Dの質感と奥行きは非常に優れています。一方で、赤い飛沫が 過剰感を強調しており、和らげる概念と少しズレます。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 4 | 全体の味を均一にする意図が伝わりやすいです |
| 比喩の明快さ | 3 | 料理の比喩は良いが、赤い飛び散りがやや強めです |
| 立体感・奥行き | 5 | シャドウと奥行きが自然で、手触り感があります |
| 映え度(SNS寄与) | 4 | 視覚的にポップで、停止しそうな印象があります |
| 色調の用語相性 | 3 | 穏やかさを伝えるため、赤の刺激はやや強いです |
| 合計 | 19 / 25 | 総合判定: 良好 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価
コメント