LLM-as-a-Judgeって、AIの“採点係”?
たとえば、模試の採点を先生がやる代わりに、もう一人の優秀な先生に「答えの丁寧さ、正確さ、例えが分かりやすさ」を見てもらい点数をつけさせるようなものです。その“もう一人の先生”が、LLM(Large Language Model、大規模言語モデル)です。
つまり、LLM-as-a-Judge(LLM-as-a-Judge、大規模言語モデルによる評価)とは、AIの出力品質を別のAIモデルに評価させる手法のことです。
人は何を採点しにくいと感じる?
AIの評価で一番面倒なのは、正解が1つだけではないことです。「この回答は親切かな」「この要約は冗長すぎないかな」といった判断は、人間が毎回やると時間がかかります。そこで評価用のLLMに基準を伝え、多数の回答を同じ視点で見てもらいます。
- カスタマーサポートの回答が、ユーザーの不安に十分答えているか
- コード生成AIのコードが、指定した仕様に合っているか
- 営業向け文章が、過度に誇張したり誤解を招く表現を使っていないか
ここでのポイントは、AIに「正しさ」を全部見せるのではなく、明確な評価基準で“相対的な品質”を測りやすくする点です。
仕組みは?
LLM-as-a-Judgeの仕組みを以下に図示します。
“採点係”の弱点は、どこにある?
LLM-as-a-Judgeは便利ですが、人間の採点のように完全に安定しているわけではありません。評価を頼むLLM自身の好みや癖が、結果に影響することがあります。
- 同じ文章を別のLLMに評価させると、順位が変わることがある
- 長い回答や、装飾の多い表現を好んで高く評価する傾向が出る場合がある
- 評価基準が曖昧だと、「丁寧さ」と「長さ」が混ざってスコアになる
だから実際には、評価用プロンプト(評価指示文)を固め、人間によるサンプル検査と組み合わせることがよくあります。
初心者として、どこから触れればいい?
いきなり本番のAI評価パイプラインを作る必要はありません。まずは、自分が「いい回答」と「悪い回答」を見分ける基準を言語化することから始めると、LLM-as-a-Judgeの意味が実感しやすくなります。
- ChatGPTやClaudeなどを使い、同じ質問で2つの回答を生成する
- 「正確さ」「簡潔さ」「安全さ」の3項目で、自分の採点基準を作る
- その3項目を指示文にして、もう一つのAIに「AとBを採点し、理由も書け」と依頼する
この作業を数回やるだけで、AI評価が“主観の比較”ではなく“基準化した点検”になる感覚がつかめます。
📚 さらに理解を深めたい方には、G検定の公式テキストがお薦めです!
だからこそ「LLMによる自動チェック(評価)」の理解が必須となる理由
今後、AIが生成するテキストやコードの量は指数関数的に増加するため、すべての出力を人間が目視で確認することはコスト・速度の面で不可能になります。実務における次の最重要課題は、「膨らむ人間の評価コストを抑えつつ、別のLLMを用いた自動品質管理(LLM-as-a-Judge)へいかに代替・移行できるか」という点にあります。
信頼できるAI運用体制を構築・議論するためには、以下のキーワードとその活用方法への理解が欠かせません。
・LLM(大規模言語モデル):文章やコードを自動生成するだけでなく、今後は「他のAIの出力を検証・採点する審査員(LLM-as-a-Judge)」として評価基盤の役割も担います。
・評価指標(Evaluation Metric):AIの回答品質を主観的な「良し悪し」で終わらせず、数値や尺度として客観的・定量的に比較・測定するための基準です。
・プロンプト(Prompt / 指示文):AIに対して役割や出力形式、そして「具体的な採点基準(ルーブリック)」を伝える入力文。AIへ厳格かつブレのない審査を委任するための重要な設計図です。
直接的に専門用語を使わない場面であっても、「AI生成物の妥当性をどう担保するか」「人間の手間を掛けずに自動チェックできる仕組みがあるか」といった運用設計まで見通せるかどうかが、今後のAI活用における大きなスキル格差につながります。
まとめ:LLM-as-a-Judgeは“便利採点係”で、最終判断官ではない
LLM-as-a-Judgeは、人間の代わりに多数のAI回答を同じ基準で見てくれる“採点係”です。便利なのは速さと繰り返しやすさですが、評価するLLM自身の好みが入るため、最終的に責任を持つ判断は人間が確認する形が安全です。
- 初心者向け:今週できる5分のアクション:同じ質問でAIに2つの回答を出させ、正確さ・簡潔さ・安全さで「なぜAが上か」を3行で書く
- 受験者向け:試験の3語の要点:「自動評価」「評価基準」「人間の最終確認」
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
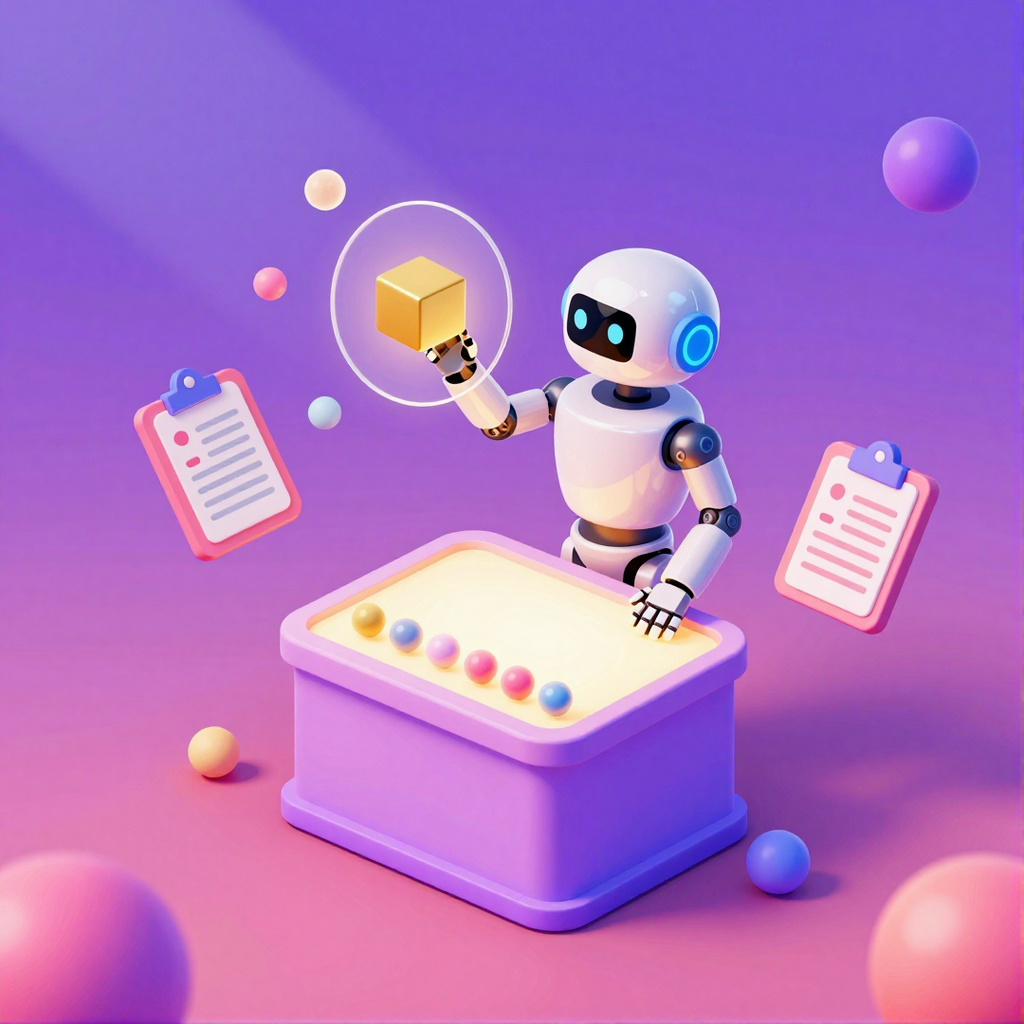
LLM-as-a-Judgeの「AIが答案を見て判定する」構造が、金色の立方体選択で分かりやすく伝わります。一方で、採点対象と採点主体の関係が少し曖昧です。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 3 | 採点感は伝わるが主体が弱めです |
| 比喩の明快さ | 4 | 黄金の選択が判定を視覚化します |
| 立体感・奥行き | 4 | 影と奥行きで空間が安定しています |
| 映え度(SNS寄与) | 4 | パステル×金属光が目を引きます |
| 色調の用語相性 | 3 | 判定の緊張感がやや弱いです |
| 合計 | 18 / 25 | 総合判定: 良好 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価
コメント