前後の文脈を「残す」仕組み
一度、文章の後半で急に意味が変わり、「あ、前にもそんな話があった」と感じたことはありませんか。長い順番データを扱うAIは、前情報をどれほど使えるかで強さが変わります。
この感覚は、AI用語としてだけ暗記するより、実際にAIを使った場面で自然に身につきます。
LSTM(Long Short-Term Memory)は、ノートに大事な情報だけを残し、ページをめくりながら読み進む「記憶を持つ読み手」という感覚でつかみやすいです。
つまり、LSTMとは、順番に並んだデータから重要な情報を選び、必要な長さにわたって記憶しながら処理するリカレントニューラルネットワーク(RNN)の1種です。
どこで「覚えていてほしい」瞬間があるか
業務でも、LSTMの考え方は「今の入力だけ」で判断しない場面に見えます。
- 翻訳や文章生成で、前の文脈を参考に次の言葉を選ぶ
- 株価やセンサーデータを予測し、数時間前の傾向まで使う
- 音声認識で、単語の並びから前後の意味を推す
たとえば、あなたがAIに「前の説明を踏まえて」と頼むとき、まさにこの仕組みが効いてきます。
この「残す/捨てる」の使い分けができるかで、AIの応答の質が変わります。
順番処理に「記憶」を足した違い
名前だけ見ると混同しやすいですが、RNN・LSTM・Transformer(Transformerは、前後の文脈を並列で照合する仕組み)は「情報を持ち運ぶ方法」が違います。
- RNN:短めの文脈は得意だが、順番が長くなるほど前情報が薄まりやすい
- LSTM:ゲート(情報を残す・忘れる・出すための制御口)で重要な情報を残せる
- Transformer:並列処理で長文向きだが、順番を「注意(attention)」で照合する
ここで押さえるのは、LSTMが「RNNを強化した記憶装置」だということです。
G検定で出やすい切り口
G検定では、RNN・LSTM・Transformerの使い分けや、時系列データ・自然言語処理への適用が問われやすいです。
たとえば「なぜRNNだけだと長い文脈が苦手なのか」「LSTMが得意なデータの特徴は何か」を自分の言葉で言えると、応用問題に強く対応できます。
G検定で「RNNとLSTMの違い」と聞かれたら、ここから答えて大丈夫です。
試験前に確認するのは、この3語が言えるかどうかです。順番、記憶、ゲート。
まとめ
LSTMは、順番データを「全部同じ重さ」で扱うのではなく、重要な情報だけ記憶に残しながら処理する仕組みです。
AIが「覚えていてほしい」場面を知ると、プロンプト(AIへの指示文)も一段磨かれます。
受験者向け:試験の3語の要点は「順番・記憶・ゲート」です
初心者向け:今週5分のアクションは、要約・翻訳で「前文のどの情報を残してほしいか」を1文で指示すること
📚 さらに理解を深めたい方には、G検定の公式テキストがお薦めです!
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
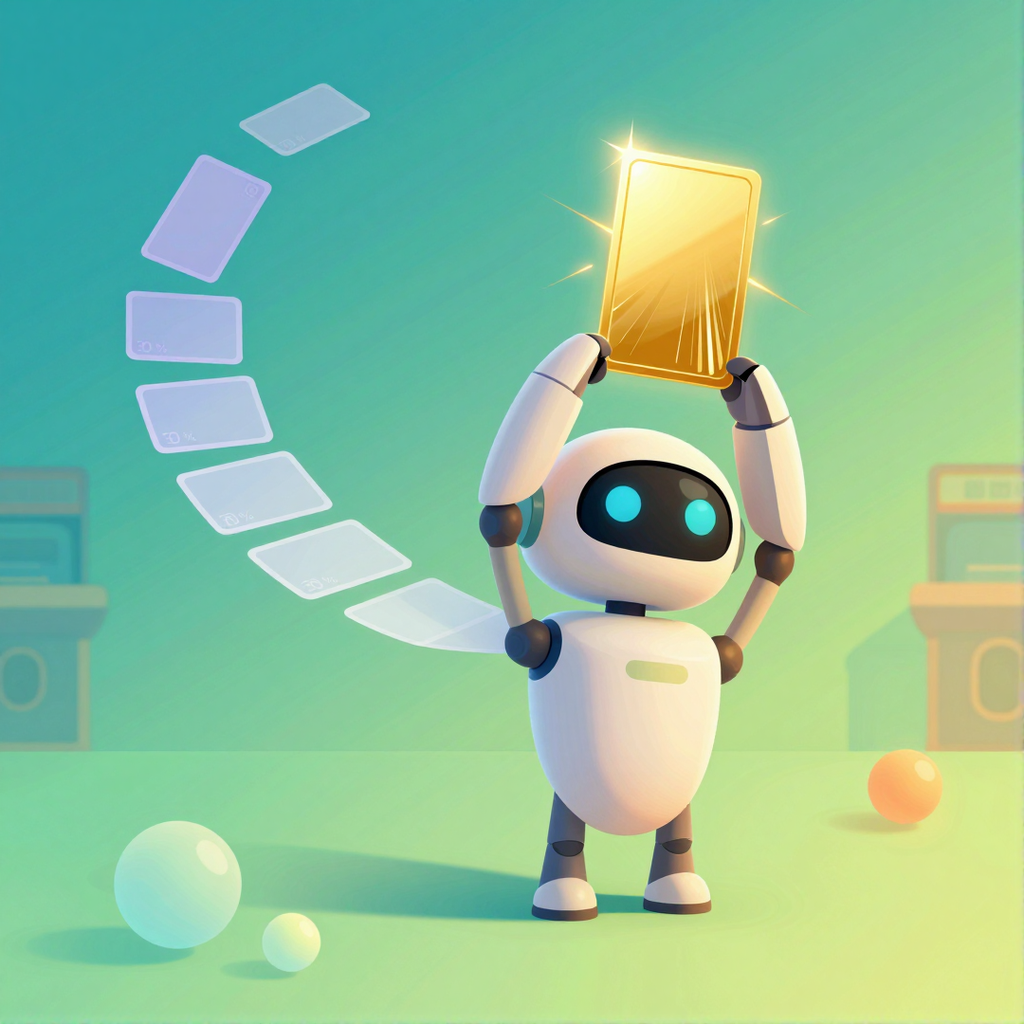
LSTMの「大事な情報だけ残し、あとは忘れる」という選択の仕組みが、金色のカードを掲げるロボットと次第に消えていくカード列で見事に表現されています。一方で、時間軸に沿って順番に処理していく感覚がもう少し欲しいところです。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 4 | 選択と解放の対比がゲートの仕組みを表しています |
| 比喩の明快さ | 4 | 金色カードvs消える列で一目で分かります |
| 立体感・奥行き | 4 | ボケと影で奥行きがしっかり出されています |
| 映え度(SNS寄与) | 4 | キュートなロボットと金のカードが映えます |
| 色調の用語相性 | 4 | 青緑基調が学習系のイメージに合っています |
| 合計 | 20 / 25 | 総合判定: 良好 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価
📒 noteで自己回帰分析のまとめを公開しています

コメント