強化学習は、ご褒美で“上手くなる”仕組み
強化学習(Reinforcement Learning)は、少し“ゲーム”の感覚に似ています。 あなたがクイズに正解すると、画面が光って「ポイント増えちゃった!」となる。 その“正解した感覚”を、機械学習のモデルが「ご褒美」として受け取るイメージです。
つまり、強化学習とは、報酬(ご褒美)をもらいながら行動を選ぶことで、 より良い選択を繰り返して“上手くなる”機械学習手法のことです。
日常で想像できる3つの場面
強化学習は、次のような日常・業務の場面を想像すると“ああ、なるほど”と入ってきます。
- 料理の味付け:塩を“少し多くしたら”、家族が「うまい」と言ったら次も同じ量にする、 という“試してご褒美で調整”の反復
- 通勤ルートの選択:渋滞で時間がかかるルートを避け、 早く到着できた道を“ご褒美”として記憶する
- 業務のフロー改善:見積もり作成の順番を“試して”、 早く納められた手順を次の業務でも採用する
ここでの“気づき”は、強化学習は“答えを覚えさせる”のではなく、 “ご褒美で行動を調整させる”点です。
試験で出たとき、自分の言葉で言えるか
強化学習は、G検定(第2次試験)やデータサイエンティスト検定で出題されやすい分野です。 特にG検定は、報酬・環境・行動の関係性を“自分の言葉で説明できるか”で確認されます。
確認方法は、1分だけかけて「強化学習とは、報酬で行動を選ぶことで上手くなる手法」 と言えたかどうか、を自分のノートに書いてみることです。
📚 さらに理解を深めたい方には、G検定の公式テキストがお薦めです!
強化学習に“似た”用語とどう違うか
強化学習と、似ているが異なる用語を3つ並べます。
- 教師あり学習:正解(ラベル)を“そのまま”教え込む学習。強化学習は“ご褒美で調整”
- 教師なし学習:ラベルなしで“パターン”を掴む学習。強化学習は“行動と報酬”が中心
- 深層学習:ニューラルネットの構造の話。強化学習は“学習の仕組み”の話
ここでの“違い”を自分の言葉で説明できるかどうかで、理解の段数が変わります。
まとめ
強化学習は、報酬(ご褒美)で行動を選ぶことで“上手くなる”機械学習手法です。 初心者は“ゲーム感覚”で捉え、受験者は“報酬・環境・行動”の関係を自分の言葉で言えるようにしておくと安心です。
- 今週にできる5分のアクション: 通勤ルートを1週間だけ“試して、早く着いた道をマークする”習慣をつけ、 その感覚を「強化学習=ご褒美で調整」とノートに1行書く
- 試験で出たときの3語の要点:「報酬」「行動」「環境」
おまけ:画像生成AIに説明させてみた
※ここからは検証コンテンツです。
画像内の説明には誤りが含まれる可能性があるため、本文の解説とは分けています。
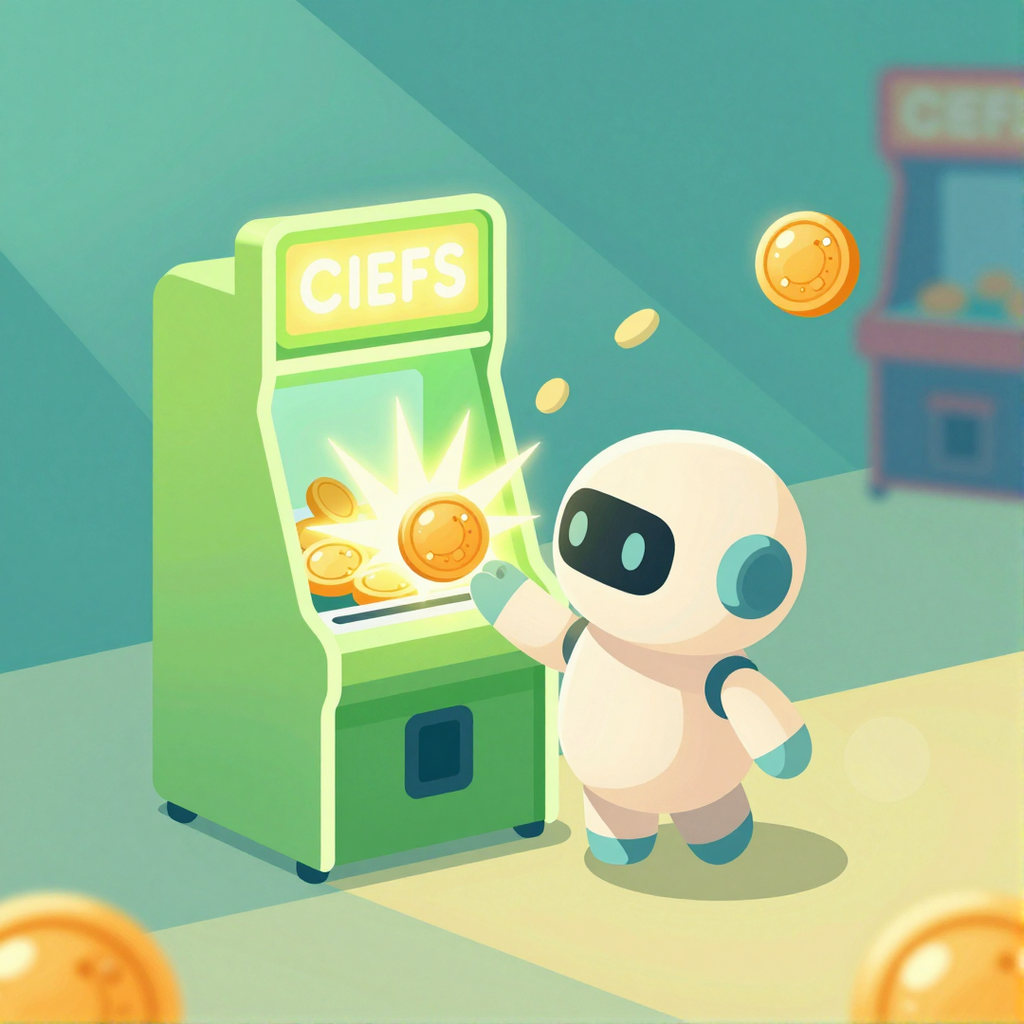
強化学習の「報酬で行動を選ぶ」という核が、ロボットとコインのゲーム風比喩でよく伝わります。一方で、パネルに文字が描かれており、無文字制約から外れている点が目立ちます。
| 評価項目 | 点数 | コメント |
|---|---|---|
| 概念の正確さ | 4 | 報酬を得る行為として強化学習に合っています |
| 比喩の明快さ | 5 | コインと光る成功報酬が直感的で分かりやすいです |
| 立体感・奥行き | 4 | 影と配置で前後関係がきれいに作られています |
| 映え度(SNS寄与) | 4 | やわらかい色味と遊び心がSNS映えにつながります |
| 色調の用語相性 | 4 | 成長や報酬の明るさによく合っています |
| 合計 | 21 / 25 | 総合判定: 優秀 |
評価基準: 1(不合格)〜5(優秀)AI Judge による自動評価
📚 このテーマをもっと学びたい方へ
まずはAIとは何かを知りましょう。名著を読むと理解が深まります!
コメント